
Fonctionnalité
BêtaUne IA privée pour vos documents confidentiels
Pour utiliser l’IA sur des documents confidentiels dans PDFBetter, choisissez IA privée dans Paramètres → Données et confidentialité → Mode de traitement IA. Le mode privé lit votre document le temps d’une requête et ne garde rien ensuite : ni index de texte stocké, ni embeddings, ni conversation enregistrée. Si l’opérateur du déploiement a configuré son propre point d’accès de modèle, les appels au modèle y sont envoyés ; sinon, ils partent vers le fournisseur d’IA hébergé avec le stockage désactivé, et la page des paramètres vous indique quel cas s’applique. Les outils qui fonctionnent dans votre navigateur sont encore plus confidentiels, car le fichier ne quitte jamais votre appareil.
Browser tools
Where it runs: Your device. The file isn't uploaded.
What's kept: Nothing on our servers
Private AI
Where it runs: Our servers for one request, then the operator's own model endpoint if configured — otherwise the hosted provider with storage off.
What's kept: Nothing after the answer: no text index, embeddings or chat
Standard AI
Where it runs: Our servers, then the hosted AI provider with storage off.
What's kept: Extracted text, search index and chat history, kept in our database
Trois niveaux de confidentialité, dits clairement
Les outils du navigateur (fusionner, diviser, faire pivoter, extraire des pages, convertir des images en PDF, entre autres) fonctionnent sur votre appareil. Le fichier n’est pas envoyé : il n’y a donc rien à conserver ni à supprimer sur nos serveurs.
Le mode IA privée traite votre document sur nos serveurs le temps d’une requête. Le texte des pages et les données de recherche restent en mémoire et sont effacés dès que la réponse est envoyée. Les réponses du chat ne sont pas enregistrées.
Le mode IA standard envoie lui aussi le texte du document au fournisseur d’IA hébergé avec le stockage désactivé, mais il conserve dans notre base de données le texte extrait et l’index de recherche de chaque document. Les questions suivantes sont ainsi plus rapides et moins coûteuses, et l’historique du chat est enregistré pour que vous puissiez reprendre une conversation.
Où partent les appels au modèle
Où partent les appels au modèle
PDFBetter peut être configuré avec un point d’accès de modèle privé compatible OpenAI : par exemple un serveur vLLM ou Ollama auto-hébergé dans l’environnement de l’opérateur. En mode privé, les résumés, le chat, la traduction et les autres fonctions de texte y sont envoyés au lieu du fournisseur hébergé.
Si aucun point d’accès privé n’est configuré, le mode privé applique quand même ses règles de non-conservation, mais les appels au modèle partent vers l’API du fournisseur hébergé avec le stockage désactivé. La page des paramètres indique si un point d’accès privé est configuré, par un simple oui ou non : son adresse n’est jamais affichée.
Ouvrez les paramètres de confidentialité
Dans votre compte, allez dans Paramètres → Données et confidentialité et repérez la section sur le traitement IA.
Choisissez IA privée
Le changement supprime immédiatement l’index IA stocké pour tous les documents dont vous êtes propriétaire. Vos documents eux-mêmes ne sont pas touchés.
Vérifiez la ligne sur le point d’accès
Elle indique si, en mode privé, les appels au modèle vont vers un point d’accès géré par l’opérateur ou vers le fournisseur hébergé avec le stockage désactivé.
Utilisez les outils IA comme d’habitude
Résumés, chat et recherche fonctionnent de la même façon, mais chaque requête relit le document et rien n’est conservé ensuite.
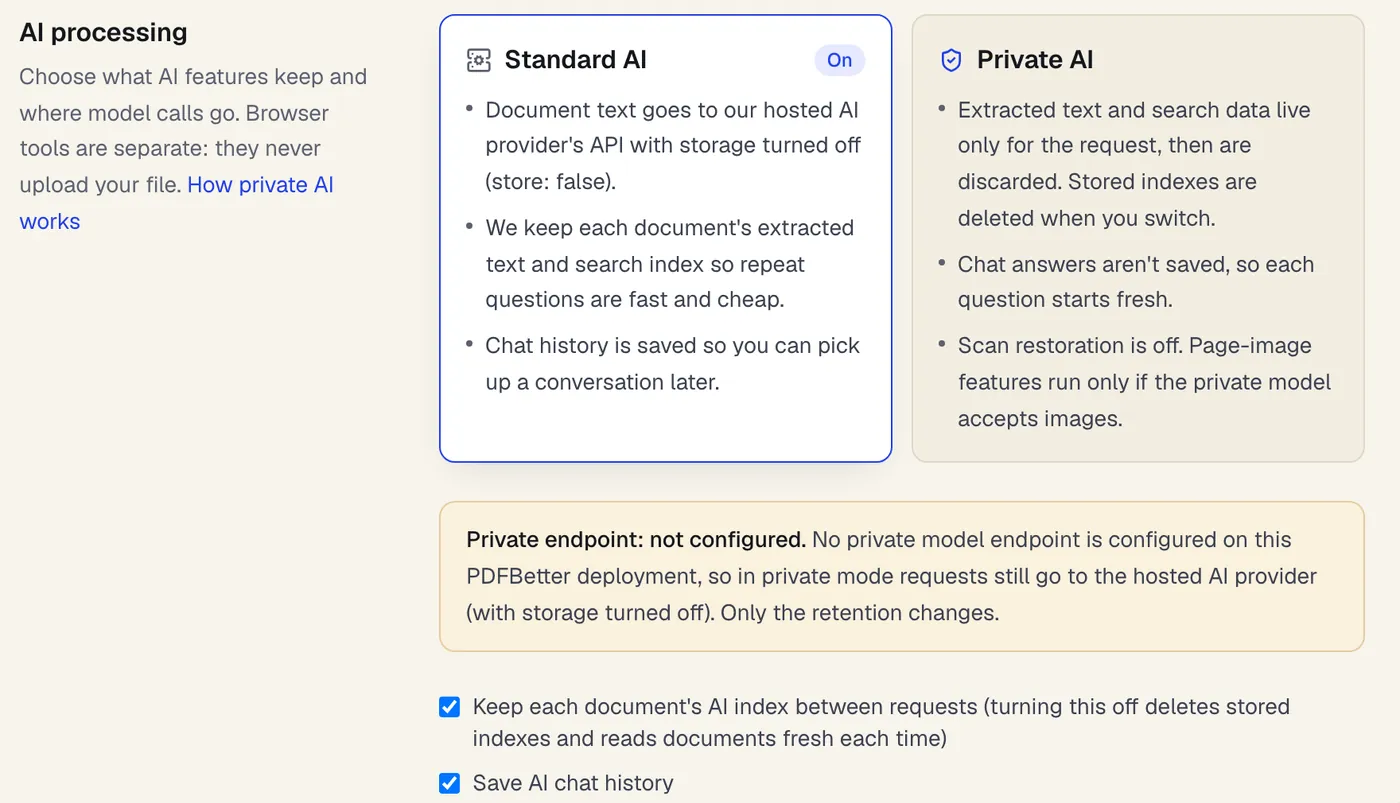
- Le mode standard garde un index du texte pour répondre plus vite aux questions répétées
- Le mode privé lit le document le temps d’une requête et ne conserve rien
- Indique si un point d’accès de modèle privé est configuré
Settings → Data & privacy → AI processing, on a deployment without a private endpoint.
Ce qui change en mode privé
Ce qui change en mode privé
La recherche par le sens utilise le modèle d’embeddings du point d’accès privé quand il y en a un. Sinon, la recherche porte sur les mots-clés : elle trouve les termes exacts, pas les reformulations.
Les fonctions qui envoient des images de pages (détection des champs de formulaire et reconnaissance de texte par IA sur les numérisations) ne fonctionnent que si le point d’accès privé accepte les images. La restauration des numérisations, qui passe par un service d’images tiers, est toujours désactivée en mode privé.
Nous testons de petits modèles d’analyse de documents, comme Granite Docling, et des analyseurs tenant compte de la mise en page, pour voir s’ils peuvent fonctionner en privé avec une bonne qualité. Ce sont des pistes en cours d’évaluation, pas des fonctions utilisables aujourd’hui.
Forfaits
Ce que comprend chaque forfait
| Gratuit | Pro | Business | |
|---|---|---|---|
| Crédits IA par mois | 20 | 500 | 2 000 |
Chaque action IA coûte un nombre fixe de crédits ; la liste complète figure sur la page Tarifs. Comparer tous les forfaits
Ce que la fonctionnalité ne fait pas
- Le mode privé n’est pas une certification de conformité. PDFBetter ne revendique pour lui aucune conformité ni certification (RGPD, HDS, SOC 2…).
- Sans point d’accès privé configuré par l’opérateur, le texte du document part quand même chez le fournisseur d’IA hébergé (avec le stockage désactivé). Seule la conservation change.
- Les documents sont relus à chaque requête : les longs documents sont plus lents, et les très longs peuvent nécessiter moins de pages par requête.
- En mode privé, le chat ne se souvient pas des questions précédentes, puisque rien n’est conservé d’un message à l’autre.
- Vos documents restent stockés dans votre espace jusqu’à ce que vous les supprimiez. Le mode privé couvre les données dérivées par l’IA, pas les fichiers que vous importez.
IA privée pour vos documents : questions fréquentes
Le mode privé signifie-t-il que mon document ne quitte jamais mon ordinateur ?
Non. L’IA privée fonctionne sur des serveurs. Seuls les outils du navigateur gardent le fichier sur votre appareil. Le mode privé signifie que rien de ce qui est tiré du document (index de texte, embeddings, réponses du chat) n’est conservé après la requête.
Qui gère le point d’accès de modèle privé ?
L’opérateur du déploiement PDFBetter le configure, par exemple un serveur de modèles auto-hébergé dans son propre environnement. Si aucun n’est configuré, la page des paramètres l’indique, et le mode privé utilise le fournisseur hébergé avec le stockage désactivé.
Que devient mon index IA existant quand je change de mode ?
Il est supprimé immédiatement pour tous les documents dont vous êtes propriétaire. Vous pouvez aussi le supprimer à tout moment depuis les paramètres, et effacer en option l’historique des conversations IA.
Pourquoi la restauration des numérisations est-elle indisponible en mode privé ?
La restauration envoie des images de pages à un service d’images tiers. Le mode privé ne le fait jamais, la fonction est donc désactivée. L’OCR sur nos serveurs de conversion reste disponible.
Le mode privé consomme-t-il plus de crédits IA ?
Non. Chaque action coûte les crédits indiqués sur la page des tarifs. Le mode privé répète simplement l’étape de lecture à chaque requête au lieu de réutiliser un index stocké.
Puis-je l’utiliser pour des dossiers médicaux, juridiques ou clients ?
Cela dépend de vos propres obligations (secret professionnel, données de santé, RGPD), pas d’un réglage. PDFBetter ne revendique aucune conformité ni certification (RGPD, HDS…) pour le mode privé. Si vos règles interdisent d’envoyer du texte à un modèle tiers, n’utilisez le mode privé qu’avec un point d’accès géré par l’opérateur, ou tenez-vous-en aux outils du navigateur.
Faut-il caviarder un document avant de poser des questions à l’IA ?
Si l’IA n’a pas besoin des données personnelles pour répondre, oui. Le caviardage assisté par IA propose de masquer les noms, numéros d’identification, numéros de carte et IBAN ; une fois le caviardage appliqué, les outils IA lisent la version caviardée du document.
Granite Docling ou d’autres petits modèles sont-ils utilisés aujourd’hui ?
Pas encore. Nous les comparons à l’extraction de texte actuelle sur des factures, des numérisations, des tableaux et des documents en turc et en anglais. Nous ne changerons de méthode que si les résultats sont meilleurs.